
在前一天的進度中,我們將七種不同維度的指標來源接入同一個 Prometheus,每秒採集約 332 個樣本,推估 90 天約累積 3.6 GiB 資料。但在那天,刻意只設定了「監控管線自身是否存活」的基礎告警,將業務與系統數值本身的告警門檻留到今天。
這項延後決定並非偷懶,而是源於一個嚴謹的觀測事實,守護程式(Daemon)在 GPU 燒機(soak)累計滿 240 秒時會強制重置任務,但在實測中,Prometheus 當時觀測到的數值往往落在 227。換言之,Prometheus 看到的時序指標永遠比現地守護程式慢。 如果告警門檻照抄守護程式的 240 秒,告警必然在守護程式動手之後才發出,這就失去了告警「提前預警」的本質。
今天我們要做三件事:
所有設定均納入版本控制並搭配單元測試驗證,確保告警規則在進入正式環境前即可確定觸發與恢復時序。
社群常見的 Grafana 配置習慣是替每種 Exporter 匯入現成的獨立儀表板,node_exporter 塞滿 40 個圖表、SNMP 一面、PVE 又一面。在實際維運中,多個儀表板切換只會增加排障時的認知負擔。
本架構堅持 單一儀表板(Single Dashboard) 原則,透過程式碼產生 JSON,並在 Grafana Provisioning 中啟用 allowUiUpdates: false。避免在 UI 介面上隨手拉圖,所有改動都必須提交至 Git。儀表板上的警戒橘線/紅線常數直接與告警規則共享,確保圖表門檻與告警觸發完全一致。
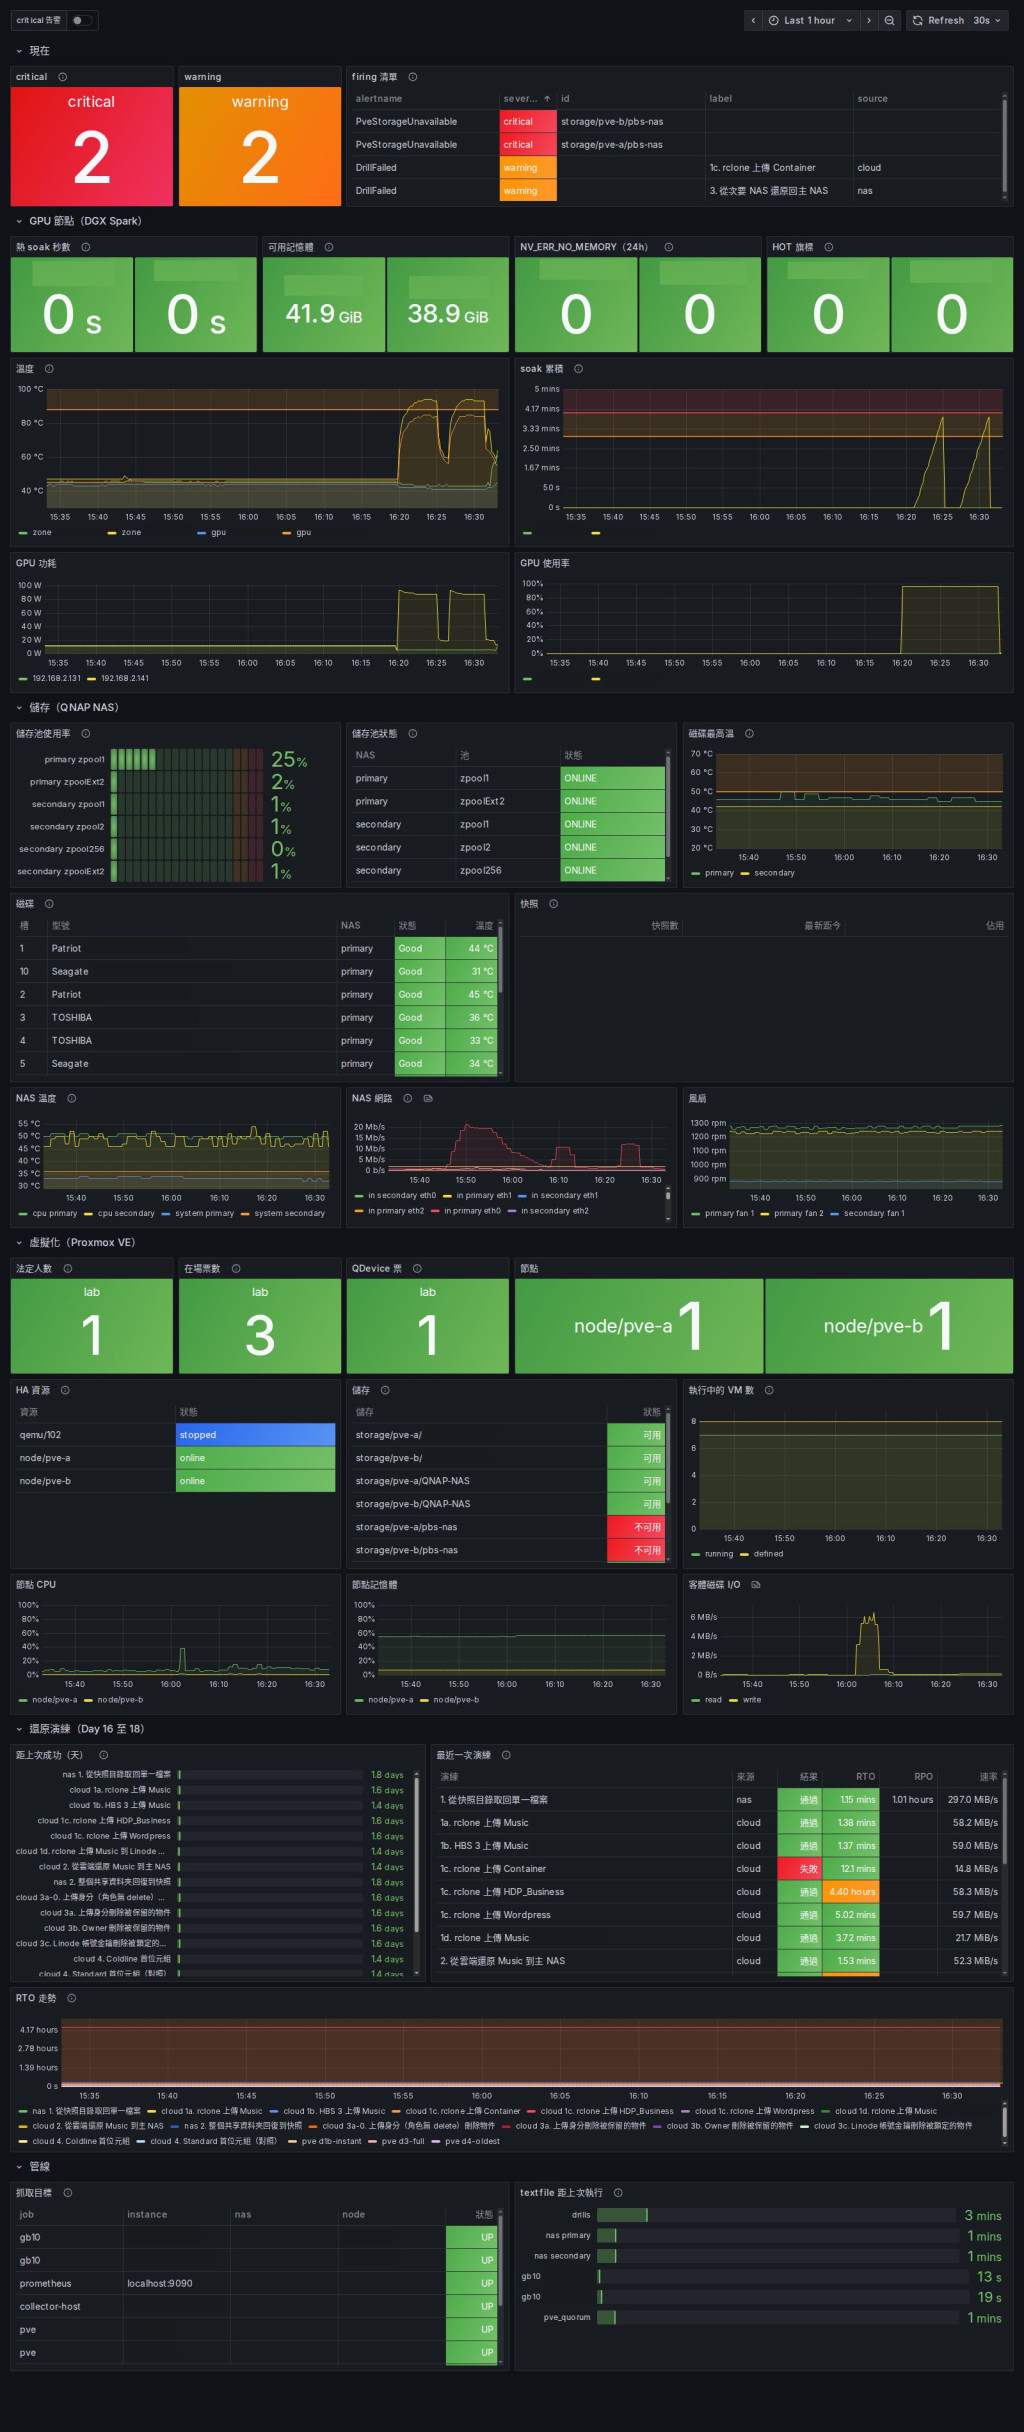
這面儀表板規劃為六列,由上而下建立清晰的資訊階層:
| 儀表板列 | 核心問題 | 關鍵面板設計 |
|---|---|---|
| 1. 現狀總覽 | 現在系統有什麼在響? | Critical 與 Warning 告警計數卡、當前 Firing 告警即時清單 |
| 2. GPU 運算節點 | 哪台節點在燒?記憶體剩多少? | Soak 秒數量表(180s 橘 / 240s 紅)、MemAvailable、NV_ERR_NO_MEMORY 增量、核心溫度與 Soak 走勢 |
| 3. 儲存子系統 | 儲存池還能撐多久?哪顆磁碟異常? | ZFS 儲存池使用率(80% 橘 / 90% 紅)、Pool 狀態、磁碟健康表、快照時間點、NAS 溫度與流量 |
| 4. 虛擬化平台 | 叢集還能容忍掉幾個節點? | 法定人數(Quorum)、在場票數、QDevice 狀態、節點列表、HA 資源狀態機 |
| 5. 災難復原演練 | 各備份最近一次證明有效是什麼時候? | 各演練距上次成功天數(30天 橘 / 90天 紅)、最近演練狀態、RTO/RPO 達標率 |
| 6. 監控管線健康 | 上述數字本身到底可不可信? | 每個 Scrape Target 的 up 指標、Textfile Collector 上次執行距今秒數 |
prometheus-pve-exporter 僅回報叢集是否具備法定人數(pve_up 為 0 或 1),看不出「當前雖有 Quorum,但已少一票、無法再容忍任何損壞」的高風險邊界。我們設計了輕量腳本,透過限制權限的 SSH 密鑰遠端讀取節點的 pvecm status,將 expected、total 與 qdevice 票數提取為指標,使 PveVoteMissing(expected - total > 0)能被即時告警。instance 標籤不同)。規則與面板必須一律透過 max without (instance) 進行聚合,法定人數則使用 min,確保任一節點判定 Quorum 遺失即觸發告警,同時避免產生重複的警報通知。告警規則切忌抄襲預設範本,所有門檻必須來自前期容量規劃與實際壓測數值。
| 規則名稱 | 觸發門檻 | 數值制定出處與理由 |
|---|---|---|
Gb10SoakNearBudget |
soak ≥ 180s,無 for,每 15s 評估 |
守護程式限制為 240s,扣除採集管線觀測延遲(最差達 45s~60s)後的前置預警時間 |
Gb10MemAvailableLow / Critical |
< 6 GiB 持續 1m / < 3 GiB 立即 | 依據壓測劃定之 Warning 與 Action 線 |
Gb10NvErrNoMemory |
10 分鐘內 Counter > 0 | Unified Memory 耗盡前的唯一可靠早期訊號 |
NasPoolAbove80 / Above90 |
> 80% 持續 30m / > 90% 持續 10m | ZFS 效能臨界線(80% 寫入降速,90% 嚴重影響 CoW 機制) |
NasPoolNotOnline |
ZFS 池狀態不是 ONLINE |
儲存池降級(DEGRADED)或異常 |
NasDiskNotGood / NasPoolStatusNotReady |
磁碟狀態 != Good / 池狀態 != ready | SNMP 實地採集之健康基準字串(需忽略大小寫) |
NasUpsNotOnline |
狀態非 online 開頭且不等於 -1 |
排除未接入 UPS 的硬體預設回傳值(-1) |
NasSnapshotStale |
最新快照距今 > 2 天且原先有快照 | 驗證自動快照排程是否如期執行 |
PveQuorumLost |
任一節點觀測 cluster 狀態為 0 |
PVE 叢集失去 Quorum,HA 機制將強制處置節點,必須無延遲發報 |
PveVoteMissing / PveQdeviceAbsent |
缺少票數 / QDevice 離線持續 2m | 叢集處於無容錯冗餘(N-1)的高危狀態 |
PveHaResourceError |
HA 狀態處於 error / fence / recovery |
虛擬機器高可用性故障狀態機捕捉 |
PveStorageUnavailable |
共享儲存不可用持續 2m | 防範 NFS / iSCSI 連線中斷引發虛擬機 I/O 阻塞凍結 |
DrillStale |
備份演練成功距今 > 30 天 | 備份系統若未經定期復原驗證,視同無效備份 |
DrillRtoOverTarget |
虛擬機復原 RTO > 900s | 根據演練量測之基準值(約 569s),訂定 15 分鐘為合規上限 |
for 子句?for: 1m 或 for: 30m)以濾除突發雜訊(Spike)。但對於累計量(如 Soak 累積秒數)或致命狀態(如 Quorum 遺失),則絕不可設定 for。Quorum 遺失後,Watchdog 通常在數十秒內就會重啟節點進行隔離防護,若等待 2 分鐘再告警,節點早已重啟完畢。Good(首字大寫)而非標準的 GOOD,PromQL 比對若忽略大小寫會直接將正常磁碟誤判為異常。因此正規表示式應統一加上 (?i) 修飾符(如 {qnap_disk_status!~"(?i)good"})。此外,列舉型指標透過 snmp_exporter 轉換後常帶有 _info 後綴,撰寫規則時需嚴格依據實際 Dump 出的指標名稱為準。告警系統中最容易被忽視的陷阱是資料傳遞與評估週期的疊加延遲。
在最初設計中,預估資料鏈路如下:
如果守護程式的殺行程門檻設為 240 秒,直覺上告警門檻設在 200 秒應該能爭取到 20~30 秒的前置時間。但在實際壓力測試中,這個推論被打破了,原因有二:
evaluation_interval 預設為 60 秒。若規則群組未獨立宣告 interval,告警評估最多可能再滯後 60 秒,整體鏈路延遲瞬間飆升至 80 秒以上,導致告警發出時守護程式早已將行程終止。單元測試工具 promtool test rules 預設會採用測試檔設定的頻率,因此本地測試會全部通過,只有實地上線才會暴露問題。
interval: 15s。+10、+21 階梯式跳躍。在壓測中,指標曾恰好停在 200 秒,下一週期直接跳至 220 秒,使得 > 200 的告警在最後一刻才被觸發,留給告警送出的前置時間僅剩 10 秒。| 測試回合 | 設定門檻 | 告警觸發時間(startsAt) | 當前觀測值 | 守護程式處置時間 | 預警提前量 |
|---|---|---|---|---|---|
| 第 1 次 | > 200 |
16:24:44.9 | 220s(前一樣本恰為 200s) | 16:24:55 | 僅提早 10.1 秒 |
| 第 2 次 | >= 180 |
16:30:29.9 | 189s | 16:31:09 | 提早 39.1 秒 |
因此,門檻正式修正為 >= 180。這爭取到的 30~40 秒提前量,即使扣除告警發送網路延遲,也能在時序紀錄上清晰呈現「先預警、後處置」,提供完整且可稽核的事後歸因軌跡。
告警若未經治理,只會淪為維運人員信箱中的無效噪音。
group_wait: 0s),每 2 小時重複提醒,對象為值班人員通訊軟體與緊急信箱。group_wait: 0s 立即推送。當機房骨幹或核心節點斷線時,底層所有衍生服務都會隨之失聯。抑制規則用於「管線死亡時,遮蔽次級數值告警」:
TargetDown(主機或 Exporter 離線)$\rightarrow$ 抑制該實例上的所有數值型 Warning 與 Info 告警。Gb10TextfileStale(指標輸出中斷)$\rightarrow$ 抑制對應節點上的運算指標告警。NasUnreachable(NAS 無法連線)$\rightarrow$ 抑制所有儲存池與快照相關告警。PveQuorumLost(叢集法定人數遺失)$\rightarrow$ 抑制 PveVoteMissing 與 QDevice 缺席告警(既然整個叢集已無 Quorum,通報少一票已毫無意義)。# alertmanager.yml 抑制規則範例
inhibit_rules:
- source_match:
alertname: 'TargetDown'
target_match_re:
severity: '^(warning|info)$'
equal: ['instance']
- source_match:
alertname: 'PveQuorumLost'
target_match_re:
alertname: 'Pve(VoteMissing|QdeviceAbsent)'
equal: ['cluster']
在例行重開機或演練期間,預期內的告警不應驚擾值班人員。維護靜音應視為變更流程的一部分:
amtool silence add 指令建立,必須明確帶有維護窗口起訖時間,並在 comment 附註變更工單(Change Request)編號。# 建立維護靜音範例
amtool --alertmanager.url=http://localhost:9093 silence add \
--duration 30m \
--author "ops-team" \
--comment "CR-2026-MAINT-01 Primary NAS Firmware Upgrade" \
'nas="primary"'
docker inspect 外洩。ALERTS{alertstate="firing"} 進行視覺化呈現,確保所有規則都能享有 Git 版本控管與 promtool 單元測試覆蓋。在非 Swarm 模式的 Docker Compose 中,以檔案掛載的 Secret 實際上等同 Bind Mount,檔案的 Linux 權限與擁有者會被直接帶入容器中。
chmod 600(擁有者為 root),Grafana 官方映像檔預設以 grafana 使用者身分執行(uid: 472, gid: 0),啟動時因無權限讀取密碼檔,啟動腳本印出 Permission denied 後竟然會靜默降級回預設密碼 admin 並照常啟動!若此服務對外暴露,將直接造成高風險漏洞。472:0 並設定為唯讀:
openssl rand -base64 24 > grafana/admin_password
sudo chown 472:0 grafana/admin_password
sudo chmod 0440 grafana/admin_password
admin/admin 登入被拒(401 Unauthorized)。在任何設定變更推送到環境前,一律在本地完成語法檢驗:
# 驗證 Prometheus 與 Alertmanager 設定檔
promtool check config prometheus/prometheus.yml
amtool check-config alertmanager/alertmanager.yml

# 執行告警規則單元測試(模擬時序數值推演)
promtool test rules tests/rules_test.yml
在收集端拉取最新設定並安全啟動:
# 準備密碼與設定
cp alertmanager/alertmanager.yml.example alertmanager/alertmanager.yml
openssl rand -base64 24 > grafana/admin_password
sudo chown 472:0 grafana/admin_password && sudo chmod 0440 grafana/admin_password

# 啟動服務並熱載入設定
docker compose up -d
curl -s -X POST localhost:9090/-/reload
在 PVE 節點配置受限 SSH Key(利用 restrict 與 command 強制限定僅能執行狀態查詢):
# 在 PVE 叢集共用授權檔中加入限制設定(/etc/pve/priv/authorized_keys)
from="<COLLECTOR_IP>",command="/usr/bin/pvecm status",restrict ssh-ed25519 AAAA... metrics@collector

# 收集端手動驗證指標輸出與 PromQL 語法
./textfile/pve-quorum-textfile.sh lab=root@<PVE_NODE_1_IP>,root@<PVE_NODE_2_IP> | promtool check metrics
透過「單一儀表板聚合視圖」與「具備出處佐證的告警門檻」,我們消除了系統維運中最常見的兩大痛點:告警疲勞與資訊碎片化。每條告警發出時,值班人員不再需要猜測為什麼是這個數字,而是清楚知道背後對應的硬體邊界或業務規範。
監控告警在系統異常時負責回答 「出事了」 ,但若要深入回答 「究竟發生了什麼事」 ,則需要完整的日誌紀錄作為拼圖的另一半。下一篇我們將探討集中式日誌管線的建置與保留政策,將節點核心日誌、叢集通訊紀錄與儲存系統日誌完整歸納收攏。
系列文章與程式碼索引:onprem-ops-30days
本日程式碼:onprem-metrics v0.2.0
參考資料
for 子句與 annotations 的模板interval 與全域 evaluation_interval
promtool test rules 的輸入格式__FILE 變數與容器的 uid 472pve_up、pve_ha_state 的定義,本文依 3.5.5 的原始碼


 iThome鐵人賽
 看影片追技術